
Tircore Cache
Cache 到底缓存什么
主要有两类 Cache:
例如:
uint32 value = table[100];
foo();
如果 table 位于可缓存的数据区域,那么对 table[100]的读取可能经过 D-Cache。
如果函数foo()位于可缓存的代码区域,那么 CPU 执行 foo()时的指令获取可能经过 P-Cache。
Cache Line
TC3xx 的指令缓存和数据缓存,操作的最小元素为Cache Line,每条都是 32 字节
一条Cache Line除了保存 32 字节的指令或数据,还关联着管理信息:
写回、失效和旁路
Cache 如何工作
假设执行:
value = (uint32_t )0x90001000;并假设 0x9... 是允许数据缓存的区域。
大致过程如下。
1. CPU 发出数据读取
CPU 计算出地址:0x90001000,硬件根据地址的最高 4 位判断它属于段 9H。
2. 判断内存属性
硬件检查:
该地址是否属于 Peripheral Space(外设空间)
该段的数据访问是否允许缓存
D-Cache 是否存在并已启用
是否有其他硬件规则强制绕过 Cache
如果最终判断允许使用 D-Cache,就查询 D-Cache。
3. 查询 D-Cache
检查对应Cache内是否有 Valid 且 Tag 匹配的行。
找到就是命中,直接使用缓存中的内容。
如果存在,称为:
Cache Hit:缓存命中CPU 直接从 D-Cache 得到数据,速度较快。
如果不存在,称为:
Cache Miss:缓存未命中此时硬件会:
从实际存储器或总线读取对应 Cache Line。
将 Cache Line 放入 D-Cache。
把 CPU 需要的数据返回给 CPU。
后续对同一 Cache Line 的读取可能直接命中。
整个过程由硬件自动完成。
DCache数据缓存是写回型(write-back)
例如 RAM 中某个变量原来为 0:
读入缓存后:        缓存 = 0,RAM = 0,Valid = 1,Dirty = 0
CPU 将变量改为 1:  缓存 = 1,RAM = 0,Valid = 1,Dirty = 1
完成写回后:        缓存 = 1,RAM = 1,Valid = 1,Dirty = 0
CPU 的修改不一定立即到达 RAM。
只要这条 dirty line 没有被替换,也没有被显式 flush,物理 RAM 里就一直是旧值。
而且每条数据缓存行只有一个 Dirty 位,因此即使只修改其中 1 字节,需要写回时仍会写回整条 32 字节。
这也是共享内存操作容易出问题的原因:CPU 和 DMA 如果分别修改同一行内的不同字节,CPU 后续的整行写回可能覆盖 DMA 的修改。工程上通常需要让共享缓冲区按缓存行对齐,并明确安排访问权限和维护时机。
内存访问类型
内存访问类型分为3类:
Cacheable Memory:可缓存内存
Non-cacheable Memory:不可缓存内存
Peripheral Space:外设空间
访问可缓存内存地址时,代码取指、数据读取都可以进入对应的Cache;同时CPU可以进行推测性取指、推测性读取;
访问不可缓存内存地址时,代码取值、数据读取不进入Cache;但仍允许预测性取指、读取,即CPU仍然可能提前读取某个地址;
对于一些外设寄存器来说,读取操作会造成寄存器复位,例如中断标志位;所以只把设备寄存器设置为“不可缓存”通常还不够,如果允许推测读取,就可能在程序真正执行读取指令前触发类似于“复位”的副作用,所以外设空间就单独设置了。
CPU的推测访问
CPU 为了提高性能,可能提前访问它认为程序随后会用到的地址,这就是 speculative access。
文档把访问分为两类:
必要访问
程序正确执行必然需要发生的访问。例如:
x = *ptr;当这条语句真正执行时,对 *ptr 的读取属于必要访问。
推测访问
CPU 为了提高性能而提前执行的访问。例如:
提前取后续指令
分支结果还没确定时,提前取某条路径上的指令
提前读取可能马上使用的数据
如果分支预测错误,某些被读取的内容最终可能根本没有被程序使用(即没有命中)。
Cache 使用限制
即使 PMA 寄存器允许缓存,硬件仍然强制执行以下限制:
外设空间永远不能缓存。
当前 CPU 的本地 DSPR (段
D)内容不能进入当前 CPU 的数据 Cache。当前 CPU 的本地 PSPR(段
C) 内容不能进入当前 CPU 的程序 Cache。
本地DSPR,PSPR指的是,当前CPU核心的DSPR,PSPR
例如Core0的DSPR,PSPR为0x7段,Core1的为0x6段
值得是各个Core访问0xD段后,解析到的地址
本地CPU访问本地DSPR不会经过Cache,因为访问速度已经足够快了(一个机器周期)
这些限制由硬件强制实施,不受 PMA0/PMA1 配置影响
注:虽然对DSPR/PSPR的本地地址访问不能进入Cache,但是全局地址访问可以配置Cache(例如Core1配置Core0 DSPR0为目标DCache地址)
默认内存属性
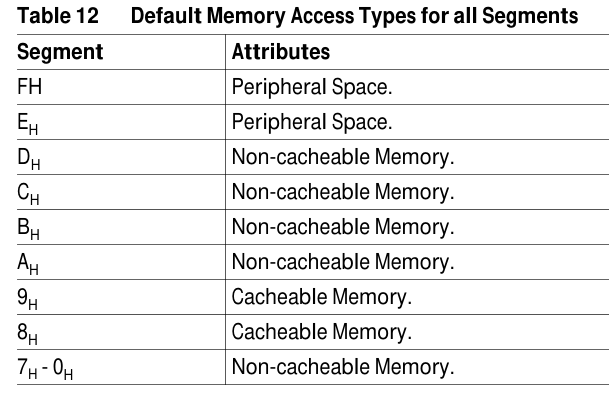
8H、9H:默认缓存
CH、DH:即使配置了也不可缓存
EH、FH:默认外设空间
其他段:默认不缓存(除C、D段都可配置缓存)
Cache相关寄存器
PMA寄存器
用途:配置缓存段
默认PMA0,PMA1为0x0300,对应位8、位9置1,对应8段、9段是缓存段
在默认的PMA0配置中,允许Cache的地址段为8段(pflash)和9段(LMU),则Core1访问Core0 DSPR是不经过Cache缓存的
默认PMA2为0xC000,对应位14、位15置1,对应E, F段为外设空间
DCON PCON寄存器
用途:使能缓存
DCON0 - Data Memory Control
DCBYP,bit 1,读写:0= DCache/DRB 可用;1= DCache/DRB 旁路/禁用。复位后为旁路状态。
DCON0受 CPUx Endinit 保护;修改前后按安全写流程管理 Endinit。其余位保留,写入 0。
DCON2 - Data Control 2(只读)
DCACHE_SZE,bits[15:0]:DCache 容量,单位 KB。DSCRATCH_SZE,bits[31:16]:Data Scratchpad 容量,单位 KB。复位值未定义(
X);读取实现容量。
PCON0 - Program Control 0
PCBYP,bit 1,读写:0= Program Cache 可用;1= 旁路/禁用 Program Cache。复位值 bit 1 为
1,即复位后 Cache 旁路。其他位保留:读作 0,写入时应写 0。
PCON1 - Program Control 1
PCINV,bit 0,读写:写1发起整个指令 Cache 失效;读回1表示失效仍在进行、指令 Cache 不可用。读回0为正常状态。PBINV,bit 1,读写:写1使 program line buffer 失效;写0无操作。该位读回恒为 0。其他位保留,写入 0。
发起失效后,需依据读回状态确认操作结束,再依芯片要求执行必要的同步操作。
PCON2 - Program Control 2(只读)
PCACHE_SZE,bits[15:0]:Program Cache 容量,单位 KB。PSCRATCH_SZE,bits[31:16]:Program Scratch 容量,单位 KB。复位值未定义(
X);用途是读取实现容量,不是配置容量。
多核Cache注意点
AURIX多核之间没有硬件Cache 一致性
CPU0 不会感知 CPU1 Cache 里的 dirty 数据,CPU1 也不会感知 CPU0 对 DSPR0 的修改。
这就要求程序开发者在设计跨核变量时,考虑Cache的一致性
跨核DSPR Cache测试
我在项目中观察到,使用Tc366双核芯片,Core0和Core1中分别有各自的APP
但是全部变量都放置在Core0的DSPR中
因为没有将两个核心的应用分开到两个c文件中,分别对应编译,并连接到各自的APP中去
根据手册,了解到各自的CPU核心访问各自的DSPR,PSPR速度是最快的,而访问别的核心的就需要通过SRI总线(System Resource Interconnect),访问速度相对较慢;具体周期可见下图所示:
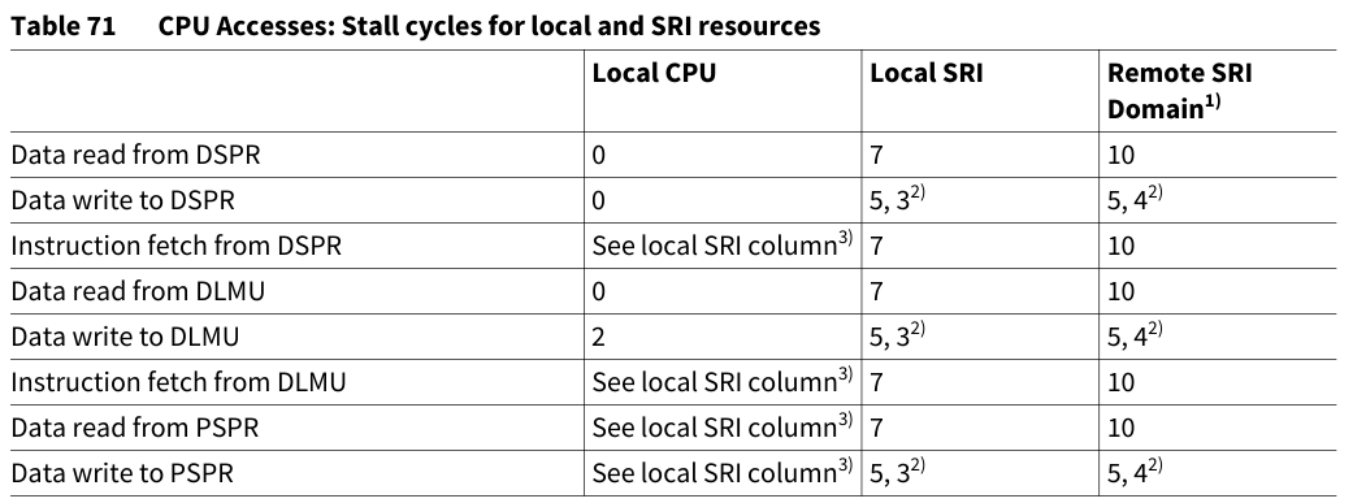
可见,Core1访问Core0 DSPR需要通过本地SRI0,需要stall(等待) 7个CPU周期,而Local CPU访问Local DSPR不需要Stall,极大的缩短了运行时间;
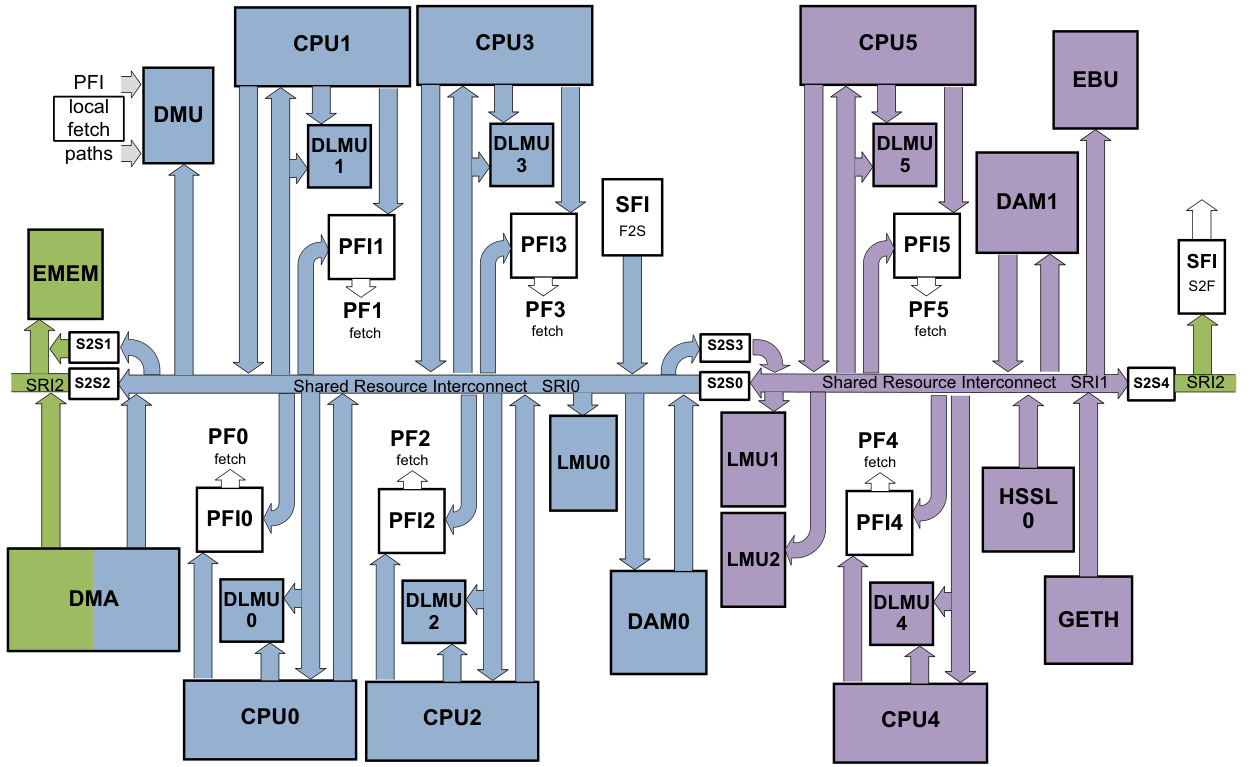
下图给出了TC3xx下的CPU架构分布图:
1. 验证本地CPU访问本地DSPR是否经过Cache
测试代码:
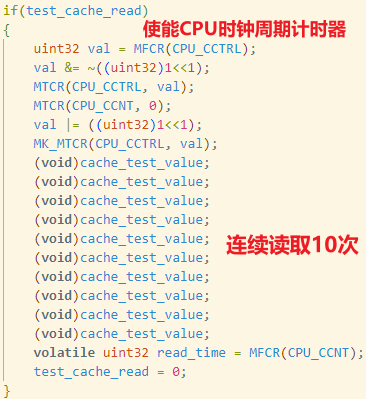
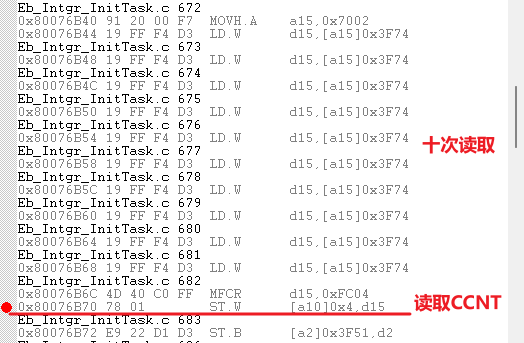
采用的相关CPU调试寄存器CCTRL(CPU Clock Cycle计数器)请查看——TriCore Performance Counter性能计数器
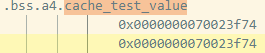
变量cache_test_value 确保在编译后定位在0x7段(DSPR0)中
测试时,保证CPU0 DCache处于开启状态(非bypass旁路)

且PCache也处于开启状态(非bypass旁路)
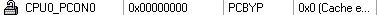
通过UDE在读取CPU_CCNT处打断点
观察d15 的值

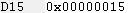
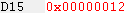
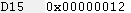
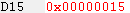
现在通过修改DCON0寄存器关闭CPU0 DCache(开启Cache bypass旁路模式)

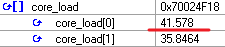
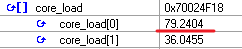
关闭DCache后,CPU负载率显著上升(因为数据读取所花费的时间变多了)
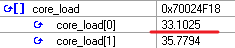
并再次测试连续读取DSPR变量所用的CPU时钟周期

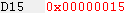
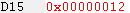
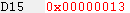
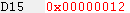
发现读取时间并没有变化,可得出结论:本地CPU访问本地DSPR不需要经过DCache
P.S. 当关闭PCache后运行时间增长,是因为CPU不从PCache中获取指令,而是直接从PFlash中取指,时间大大增加了;
2. 验证非本地CPU访问非本地DSPR
Core1访问Core0 DSPR0,
在泛亚CEPS项目中,各个APP并没有分开放到不同的C文件中去,导致全部的变量都存放在DSPR0中;
这就导致了CPU1必须通过SRI总线访问CPU0的DSPR,这种访问通常情况下需要stall等待7个CPU周期;
测试逻辑代码与前面相同:
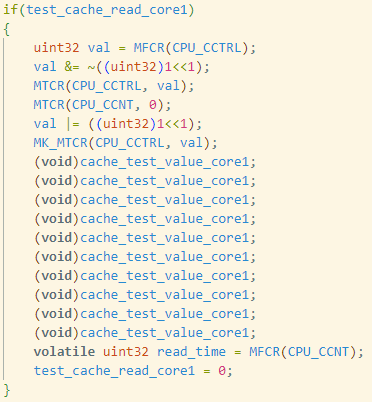
首先要确保的是cache_test_value_core1存放在DSPR0中
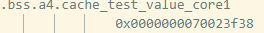
同时CPU1的DCache是开启的

经测试后发现
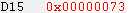
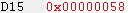
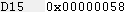
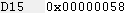
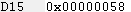
对比发现,10次DSPR读取增加了大概70个CPU时钟周期,对应每次读取所等待7周期时间,共7*10
后面也测试了关闭CPU1 DCache的情况下,结果相同
所以可以得出结论:CPU读取非本地DSPR比较耗时
这也可以提供一个降低CPU负载率的思路:将Core1应用的用到的变量应该放到本地DPSR1中
或者,让CPU1 DCache缓存DSPR0
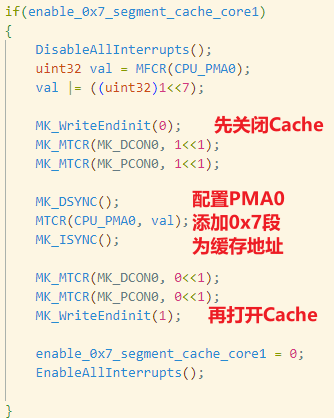
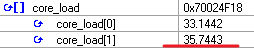
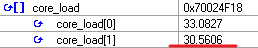
打开后,Core1负载率显著下降5%(没开预驱,且电机控制不使能条件下)
目前项目这样修改的缺点:
由于Core1中运行APP所使用的全部变量都放置在DSPR0中(非本地CPU DSPR)
当CPU1将0x7段使能DCache缓存后,会将用到的变量转存到自己本地DCache中
又由于DCache的Write-back策略特性,变量全部的load-store操作,全部在本地DCache中已经完成了,根本不需要写回到DSPR0中去!
这就导致物理地址范围(变量对应的DSPR0地址值)仍然保持不变,
就会出现:在UDE中观察不到变量变化,Core0读取不到最新Core1修改的变量值。
所以,当使用跨核心的共享变量的时候,强制!必须!不能!使用Cache缓存共享变量
或者,使用Cache相关指令刷新对应的Cache,强制使其写入到物理地址中去。
多核共享DLMU测试
TC366没有LMU,但是有DLMU(Distributed LMU SRAM,分布式LMU)
CPU0对应的为DLMU0,地址范围0xB000,0000-0xB000,FFFF;
CPU1对应的为DLMU1,地址范围0xB001,0000-0xB001,FFFF;
DLMU是按CPU分布的,每个CPU都有本地的LMU,
CPU访问本地LMU速度和DSRP一样快,load-store操作同样不经过缓存
通常可以通过0x9段缓存访问方式和0xB段非缓存访问方式来访问DLMU。
通过0x9段缓存访问DLMU需要注意:
Core0访问DLMU0(地址0x9000,0000-0x9000,FFFF),为直接访问,不经过Cache;
Core0访问DLMU1(地址0x9001,0000-0x9001,FFFF),经过Cache,回写存在延迟,需要手动管理Cache
同理,Core1访问DLMU1为直接访问,访问DLMU0经过Cahce
验证过程:
Core0写入存放在DLMU0中的变量cache_dlmu0 ,Core1通过Cache和None-Cache两种方式读取
在ld中定义变量链接地址:

编译完成后在map中查看:
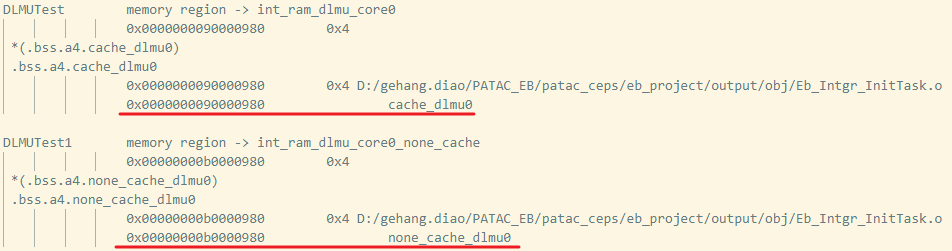
在Core0_1ms_task中写入变量cache_dlmu0 ,然后从Core1_1ms_task中读取cache_dlmu0 和none_cache_dlmu0
发现Core0写入后,Core1读取Cache变量的初始值0,但读取None-Cache变量为最新值
这是由于Core1在读取变量cache_dlmu0 时,在DCache中找到了(缓存命中),直接从本地Cache中取出旧值;
Core0对DLMU0的读写并不会报告给DCache1,所以DCache1中的变量依然为Clean的,不会触发从DLMU0中重新读取
而通过none_cache_dlmu0 读取时,不经过DCache,直接从物理内存中读取,所以可以读取到最新值
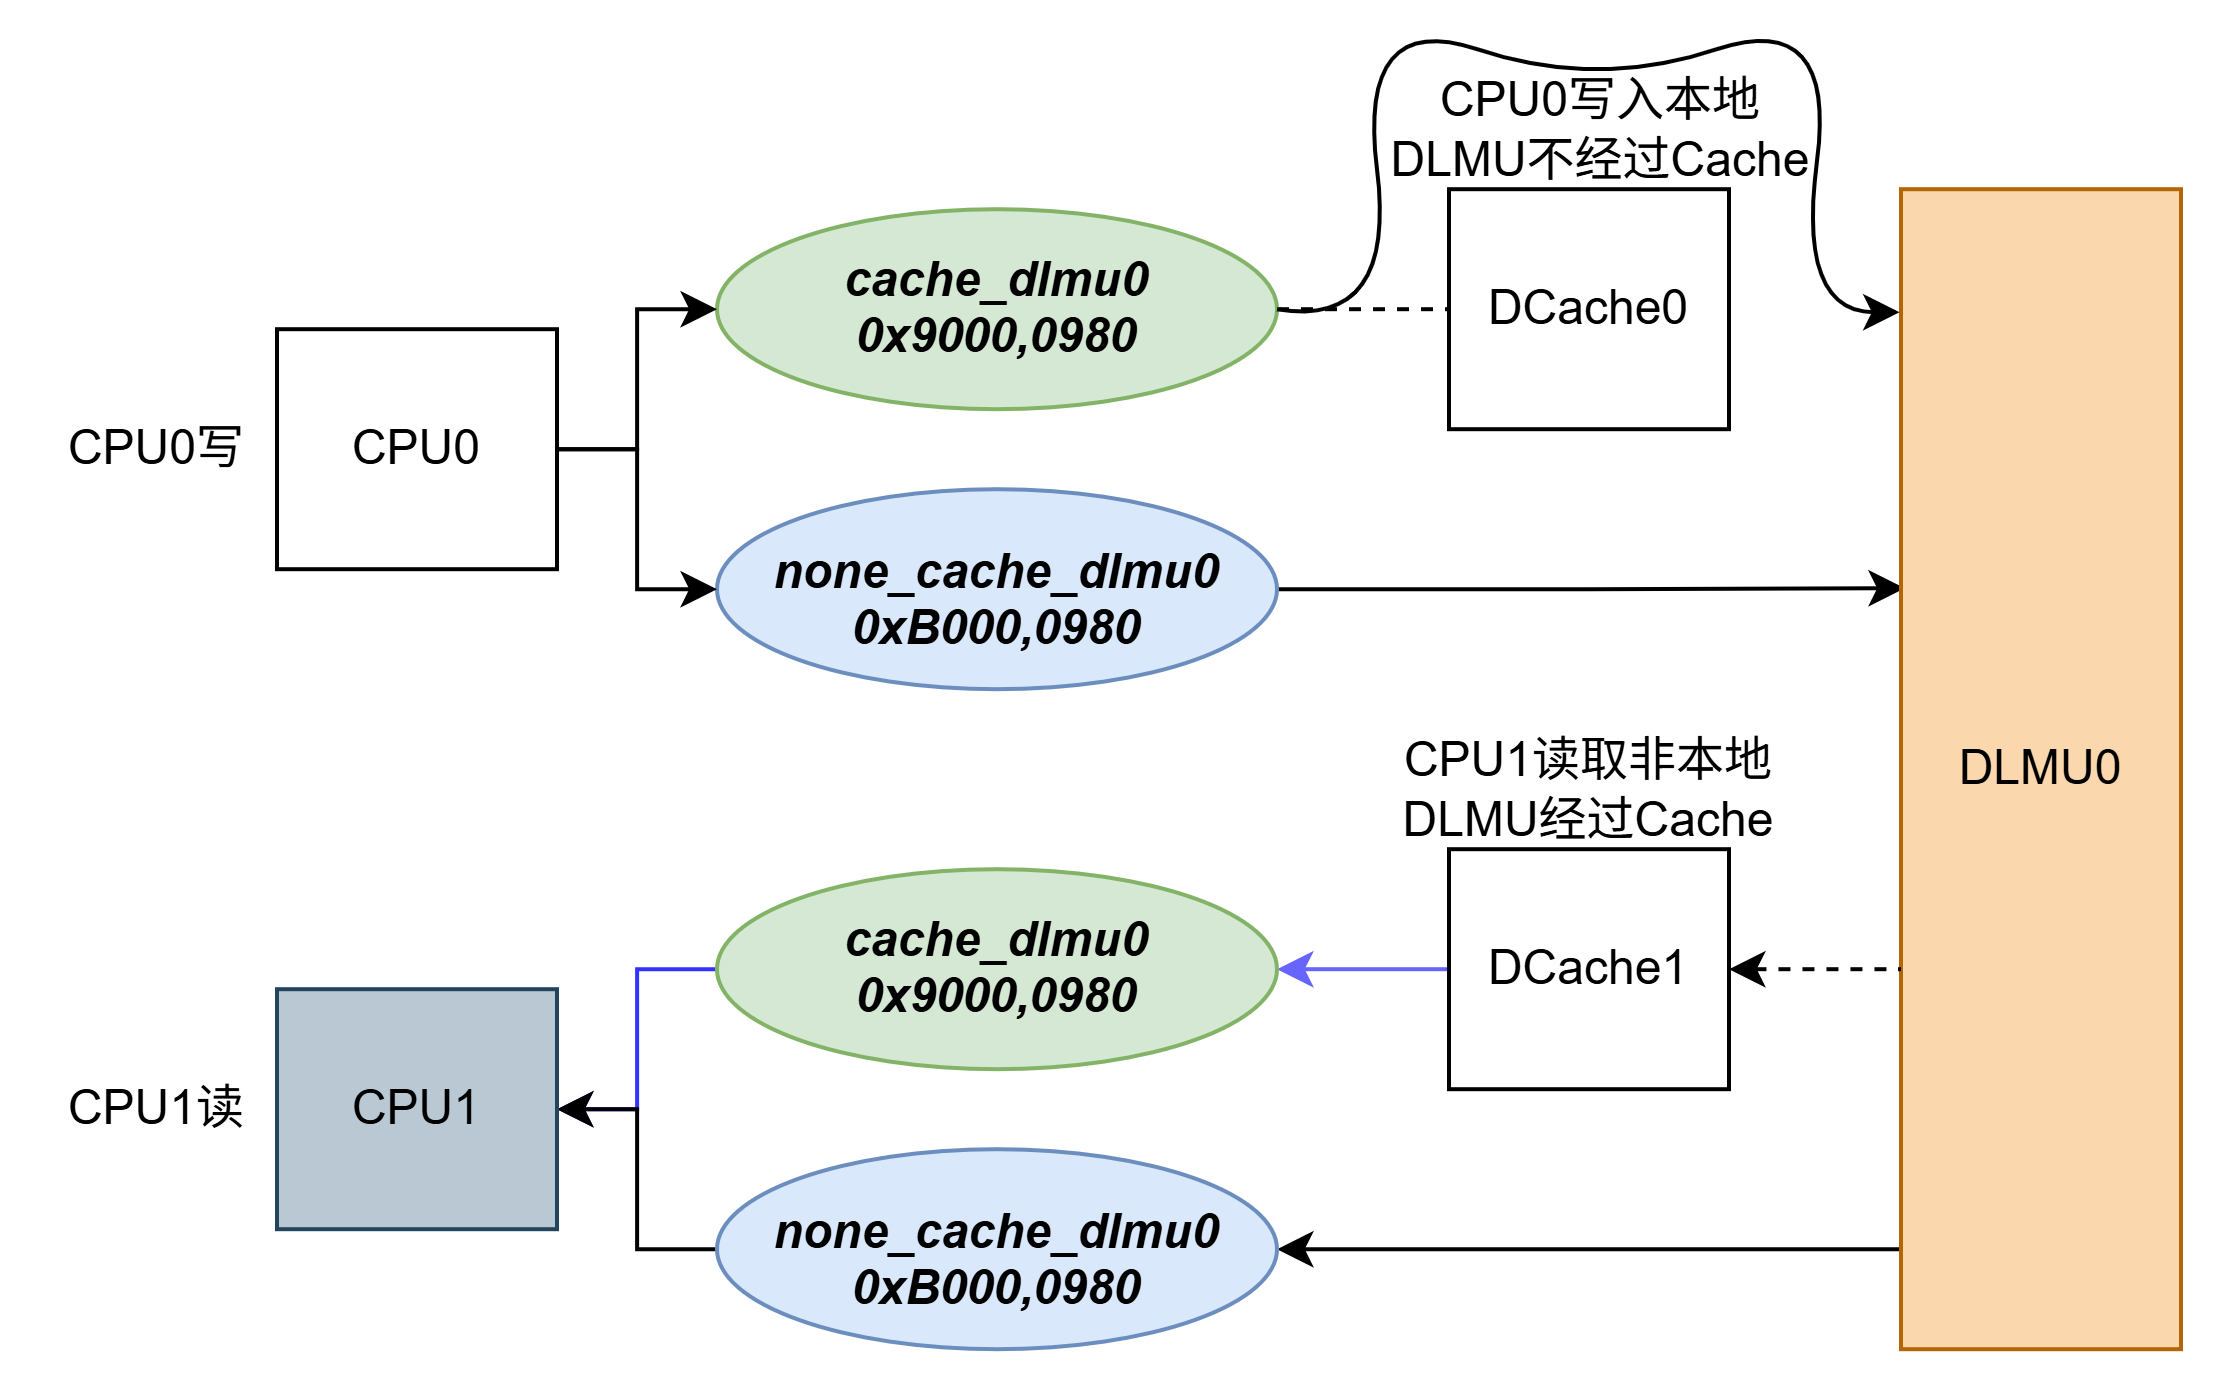
这种情况下,共享变量强烈建议直接使用非缓存地址读取,如有缓存要求,可以通过软件维护缓存指令,使缓存中变量失效,从而使缓存重新从DLMU0物理地址中读取。
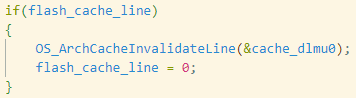
其原理是调用CACHEA.I 指令
类似的,CPU1通过Cache写DLMU0中变量也没办法及时更新到物理内存中去,
可以通过缓存写指令CACHEA.W 将其写回;